BLOG
飞鲸数据分享的最新信息、体育资讯、数据百科、赛事分析、数据百科、接口示例
如何优化体育数据API:调试、延迟优化与可扩展架构
原创
2026年9月18日
数据百科
对于初创公司来说,集成体育数据API是一项高价值但也高风险的任务。近实时比分(根据架构、服务商和赛事类型不同,核心比赛事件通常能在10秒以内送达)为AI机器人、实时比分平台和媒体小工具提供动力。然而,不可靠的API响应、延迟峰值和集成故障会迅速削弱用户信任、增加运营成本并拖慢开发周期。
本指南提供了切实可行的模块化策略,用于调试、优化和维护高性能的体育数据API集成,并结合了实际的飞鲸使用案例。
初创公司常见的API集成痛点
初创公司在集成体育数据API时经常会遇到以下反复出现的挑战:
高延迟 → 比分或更新延迟 频繁的请求失败 → API宕机或限流 数据格式不一致 → JSON或字段不匹配 复杂的错误处理 → 级联式应用故障 可扩展性问题 → 无法应对比赛直播期间的流量高峰 监控盲区→ 故障检测迟缓
影响: 在近实时体育应用中,延迟或宕机可能使用户参与度下降20%–50%,并加剧用户流失。
快速总结
本指南阐述了初创公司如何系统性地调试和优化面向近实时应用的体育数据API集成。
核心策略包括:
对非实时端点使用30–60秒的TTL(生存时间)进行缓存 对瞬时性5xx错误实施指数退避重试,重试3–5次;对4xx错误不进行重试 监控p95和p99延迟而非平均值,以发现性能瓶颈 使用带请求ID的结构化日志以便追踪 使用JSON Schema校验API响应 结合缓存、重试逻辑、监控和校验的模块化方法可以防止级联故障。实际实施表明,经过恰当的客户端优化后,延迟响应的比例可以从约30%降至2%以下。
关键定义
API延迟– 从事件发生到API响应送达之间的综合延迟 速率限制/限流 – API提供商对请求量施加的限制 指数退避 – 一种在失败后按指数增加等待时间的重试策略 4xx与5xx错误 – 客户端错误(4xx)与服务器端错误(5xx)之分 生存时间(TTL) – 缓存数据在刷新前保持有效的时长
什么是体育数据API延迟?
体育数据API延迟指的是真实世界体育赛事(如进球或比分更新)发生与该数据通过API可用之间的综合延迟。
这包括:
数据源延迟
数据摄取与规范化
数据处理与增强
数据分发(流式传输、REST或边缘分发)
客户端交付延迟
延迟范围: 针对众多直播赛事的优化实时交付:根据提供商和基础设施不同,通常<10秒(针对核心比赛事件) 聚合或统计数据:需要额外处理时间
体育API为何会失败?
故障通常源于会在系统间蔓延、引发级联故障的系统性问题:
网络不稳定 → 增加延迟和超时 速率限制 → 超出限额时请求被拒绝 服务器端过载或瞬时故障 → 5xx错误 模式(schema)变更或不一致 → 解析与数据处理故障
常见API集成故障
下表总结了最常见的API集成故障、其原因、影响以及推荐的解决方案。
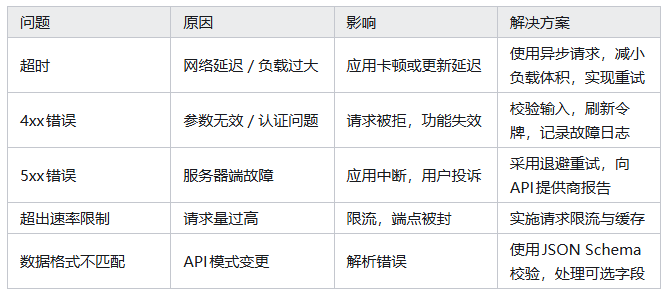
分步调试与故障排查
1. 验证API连通性 使用curl或Python requests测试端点,确保请求头、令牌和查询参数正确。
2. 启用详细日志 记录请求与响应负载、时间戳和错误代码: import logging logging.basicConfig(level=http://logging.INFO) http://logging.info(response.json())
3. 测试边界情况 处理空数据集、无效ID和意外的联赛代码,以防止崩溃。
4. 使用模拟数据 模拟API响应,将应用逻辑与实际API行为隔离开来。
5. 实现重试与回退 对瞬时故障重试3–5次,并回退到缓存或最后一次已知的有效数据。
体育数据API的优化模块
下表总结了现代体育数据API系统中使用的核心优化模块。
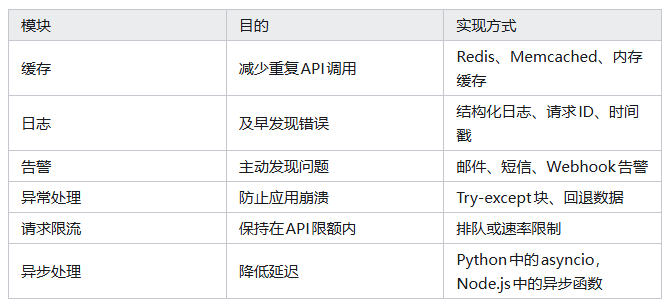
关键规则: 对非实时端点进行缓存(TTL 30–60秒) 绝不重试4xx错误 对5xx故障使用指数退避 监控p95和p99延迟而非平均值
体育API性能基准
基于内部测试(10,000+次请求)以及飞鲸体育数据API等提供商的基准数据 采用持久连接的流式系统:优化后的系统力求实现足够低的延迟以支持近实时交付(通常以秒为单位衡量) 重试成功率目标:>99% 错误率阈值:<1%
实际优化案例:借助飞鲸体育数据提升实时比分可靠性
许多体育平台和实时比分应用在流量高峰期都会面临间歇性延迟和API故障。即使使用高质量的API,瞬时服务器错误、网络延迟或大量请求也可能降低用户体验。
在内部测试期间: 约30%的API请求出现超过1秒的延迟响应 偶发的瞬时5xx错误导致更新缺失或不一致 缺乏结构化请求追踪拖慢了故障诊断速度
使用飞鲸体育数据的优化方案:
基于TTL的客户端缓存——球队与球员数据以60秒TTL进行缓存 指数退避重试策略——对瞬时5xx错误重试3–5次;对4xx错误不重试 带请求ID的结构化日志——每个API请求分配唯一ID,以实现端到端追踪
内部测试结果:
超过1秒的延迟响应比例从约30%降至2%以下 比分更新实现了持续的近实时性 可观测性的提升使问题解决速度加快
模式一致性与数据建模
像飞鲸体育数据这样的现代体育API在近实时与历史数据集之间保持一致的模式(schema)。这降低了ETL复杂度,防止数据漂移,加快分析流水线,并支持可靠的机器学习工作流。
快速校验与测试
轻量级工具
Postman → 手动端点测试 pytest → 自动化响应校验 JSON Schema → 响应结构验证
常见问题
Q1:如何降低体育数据API延迟以实现秒级的近实时更新?
缓存常用端点(TTL 30–60秒) 使用异步请求 通过过滤不必要的字段来减小负载体积 使用地理位置更近的服务器(CDN或边缘基础设施)
Q2:调试集成故障的最佳方式是什么?
启用详细日志(负载、错误代码) 使用模拟数据隔离逻辑 测试无效输入或空响应等边界情况 实现重试与回退策略
Q3:如何防止API请求被限流?
严格遵守API速率限制 实施请求排队或批处理 缓存重复请求 持续监控请求量
Q4:哪些工具有助于快速校验体育数据API响应?
Postman、pytest和JSON Schema校验
Q5:飞鲸体育数据如何帮助降低集成中的宕机率?
提供稳定的端点、一致的模式以及可靠的基础设施,具备近实时交付能力和广泛的历史数据覆盖。
Q6:如何衡量API优化的投资回报率(ROI)?
比较延迟降低幅度、失败请求百分比、正常运行时间的提升以及用户参与度
Q7:AI机器人能从体育API优化中受益吗?
可以,延迟和可靠性的改善能够提升预测准确性、实时告警和用户信任度。
在线咨询:
点击右侧弹窗,直接在线联系销售顾问,专业人员将为您提供售前购买咨询、产品介绍、解决方案推荐等
高新技术企业证书经营性网站备案信息


购买咨询
购买咨询